Si tu poses la même question à ChatGPT aujourd’hui et demain, tu obtiendras souvent deux réponses différentes. Parfois ta marque est citée, parfois non. La visibilité IA est-elle seulement mesurable ?
- Les réponses individuelles de l’IA relèvent bien du hasard
- La question clé : répéter ou élargir ?
- Pourquoi la diversité l’emporte
- De nombreux prompts lissent les fluctuations
- Quand les requêtes quotidiennes restent utiles
- Précis ne veut pas dire juste
- Dans ton propre ensemble : stable pour ta marque, incertain pour les concurrents
- Ce qu’il faut en retenir
Elle peut être mesurée de manière fiable, mais pas comme le suggèrent beaucoup d’outils et de guides. Nous avons analysé 10 826 séries de mesures quotidiennes issues des données SISTRIX, sur quatre modèles d’IA et huit pays. Le résultat est sans appel : pour obtenir des chiffres fiables, il ne faut pas interroger le même prompt encore et encore, mais un maximum de prompts différents.
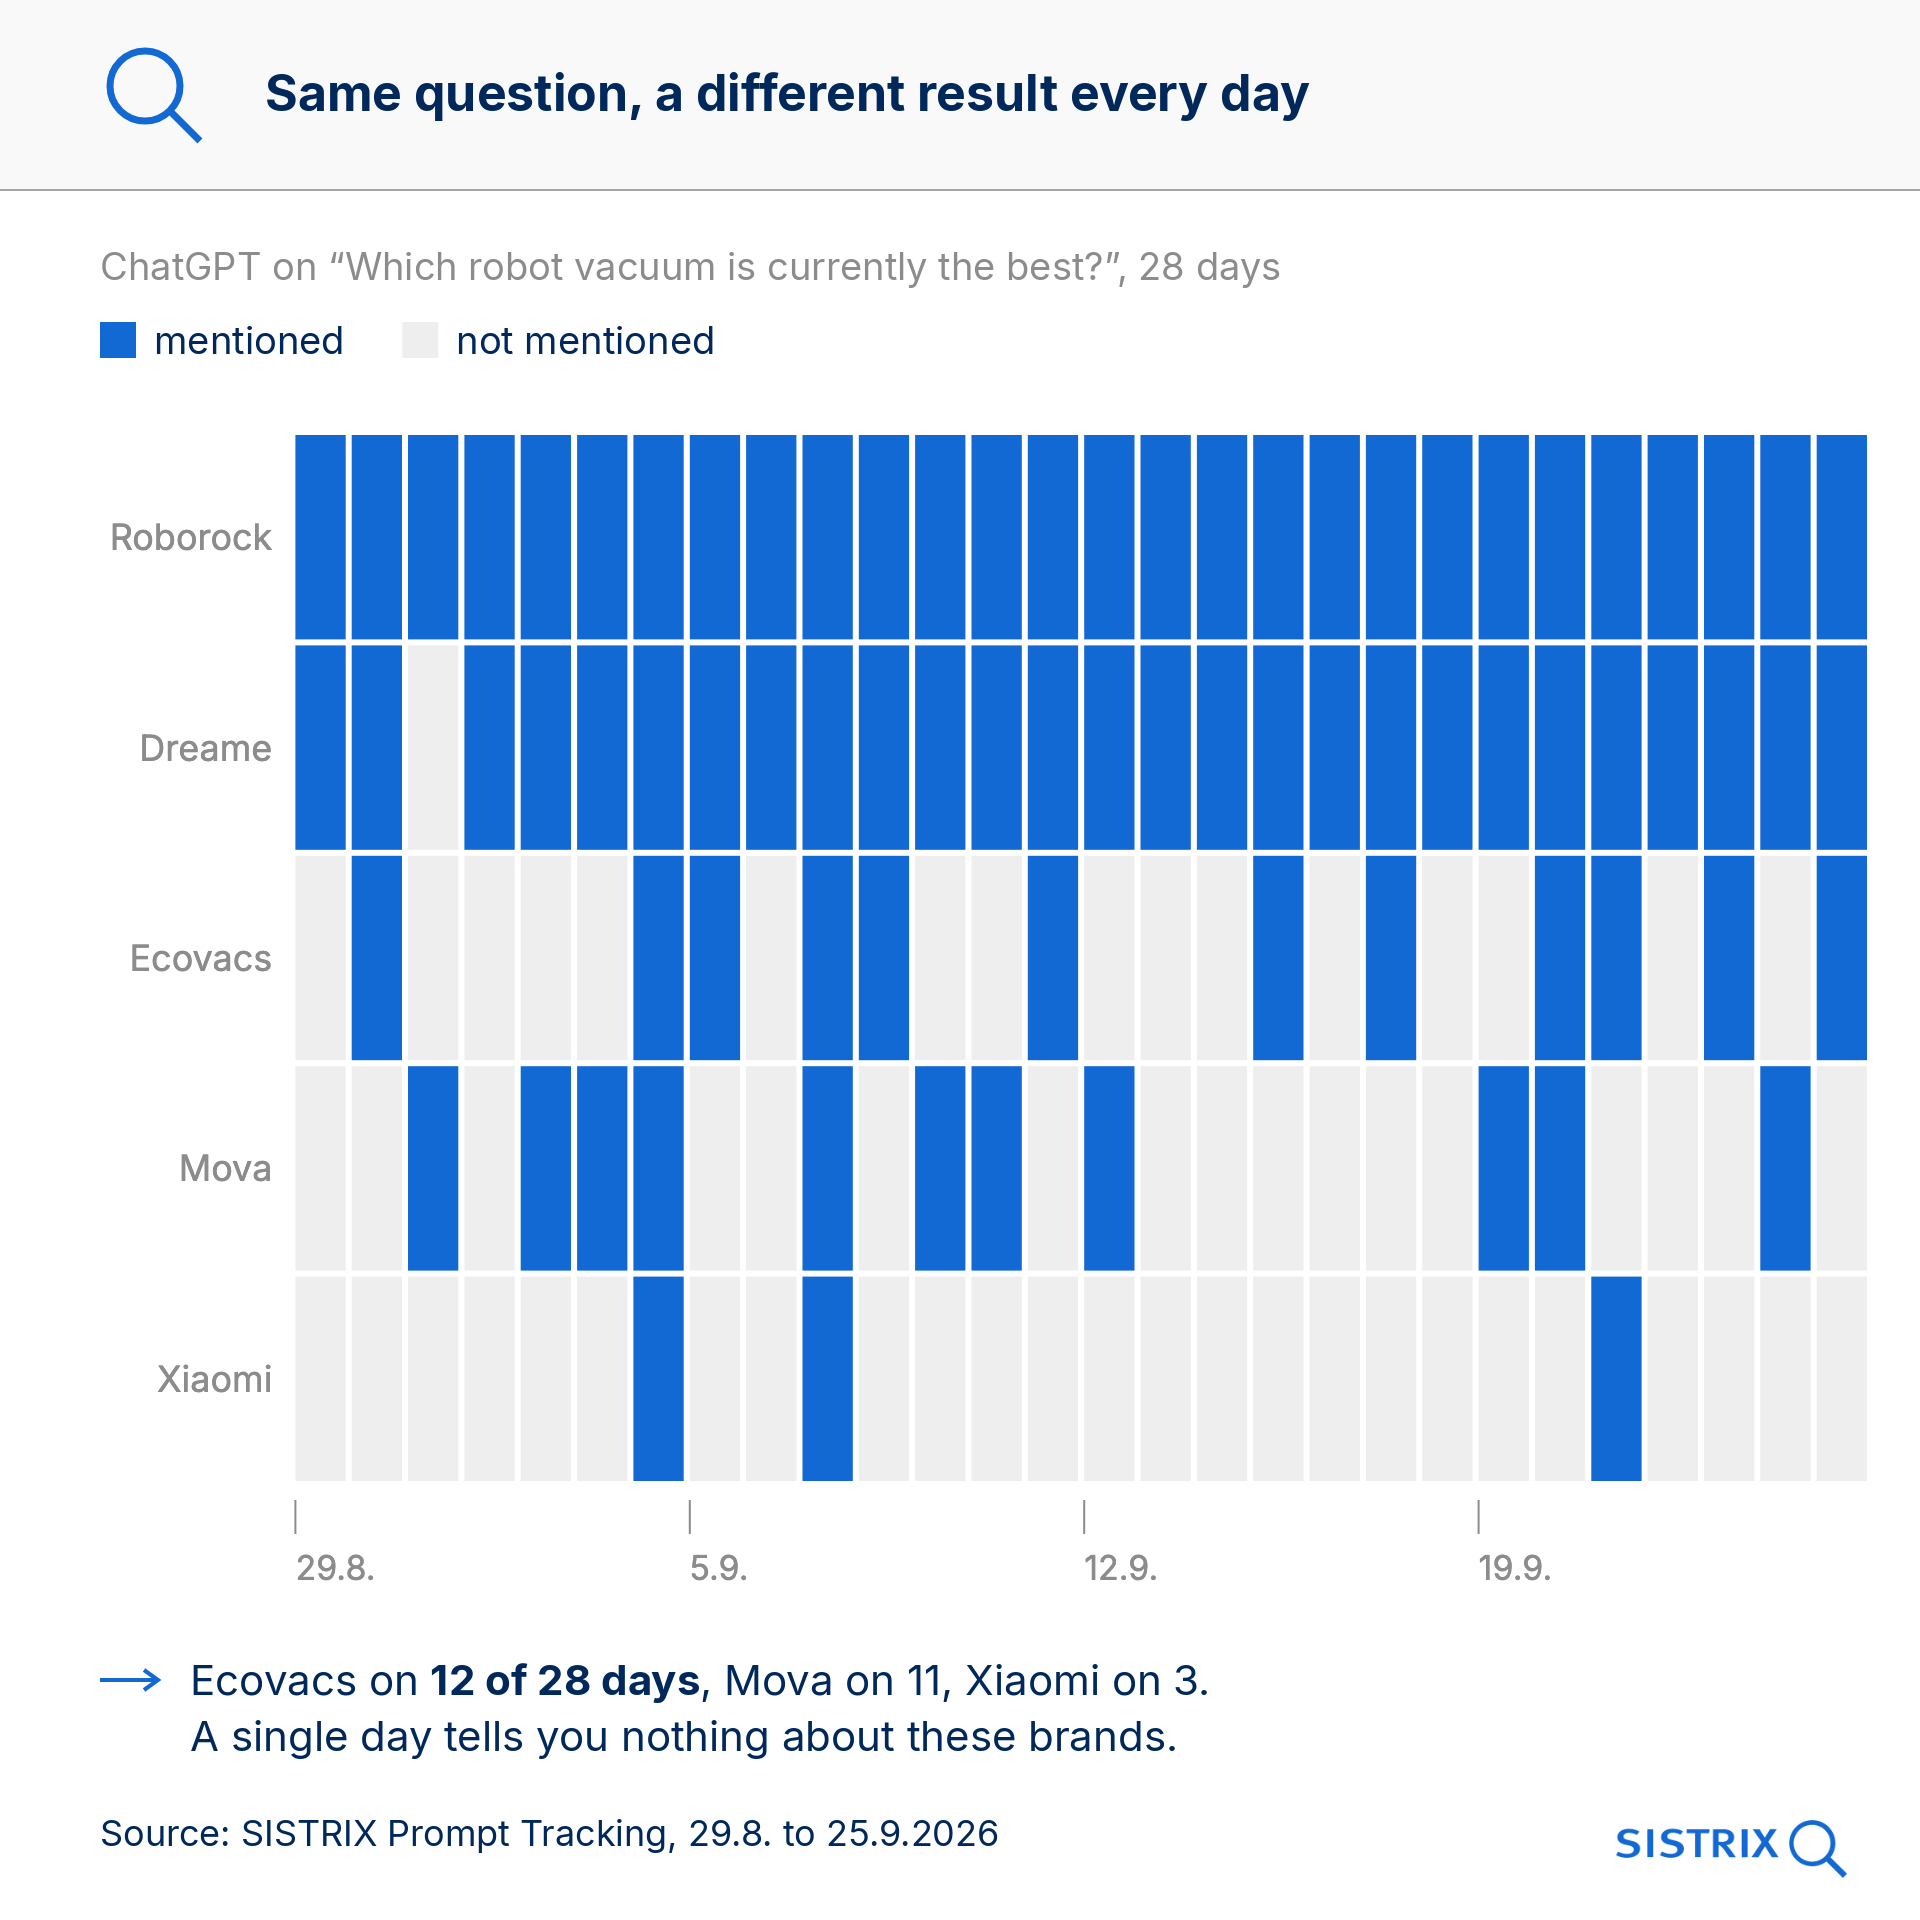
Un exemple tiré de notre Prompt Tracking : chaque jour, nous demandons à ChatGPT « Quel est actuellement le meilleur robot aspirateur ? ». Sur quatre semaines, Roborock et Dreame sont cités presque tous les jours. Ecovacs apparaît 12 jours sur 28, Mova 11 et Xiaomi 3, sans schéma identifiable. Si tu regardes un seul jour, tu n’apprends donc presque rien sur ces trois marques.
Les réponses individuelles de l’IA relèvent bien du hasard
Dans un article qui vaut vraiment la lecture, intitulé « There Is No “Accuracy” in AI Search Tracking – Only Precision », Mike King, d’iPullRank, a récemment montré à quel point les réponses de l’IA varient d’une exécution à l’autre. Il s’appuie sur une expérience de Mike Sonders portant sur 12 prompts, avec 100 exécutions chacun dans ChatGPT : 72 % des marques apparaissaient dans moins d’une réponse sur cinq.
Nos données le confirment sur une base bien plus large. Parmi toutes les marques présentes dans les réponses à un prompt, 70 % apparaissent moins d’un jour sur cinq. Seules 6 % sont présentes au moins quatre jours sur cinq. Cela vaut aussi bien pour ChatGPT que pour AI Overviews, AI Mode et Perplexity.
Une réponse isolée ne dit donc pas grand-chose. Toute la question est de savoir comment transformer de nombreuses réponses incertaines en un chiffre fiable.
La question clé : répéter ou élargir ?
Supposons que tu disposes d’un budget de 20 requêtes. Tu peux interroger un prompt pendant 20 jours, 20 prompts différents une fois chacun, ou toute combinaison intermédiaire. Quelle répartition donne la réponse la plus précise à la question « Dans combien de réponses ma marque apparaît-elle ? »
La réponse issue des 10 826 séries de mesures est claire. Supposons qu’une marque apparaisse en réalité dans 25 % des réponses. Si tu interroges un prompt pendant 20 jours, ta mesure peut se situer n’importe où entre 0 et 59 %. Avec 20 prompts différents sur une seule journée, elle se situe entre 16 et 35 %, et avec 100 prompts, entre 21 et 29 %.
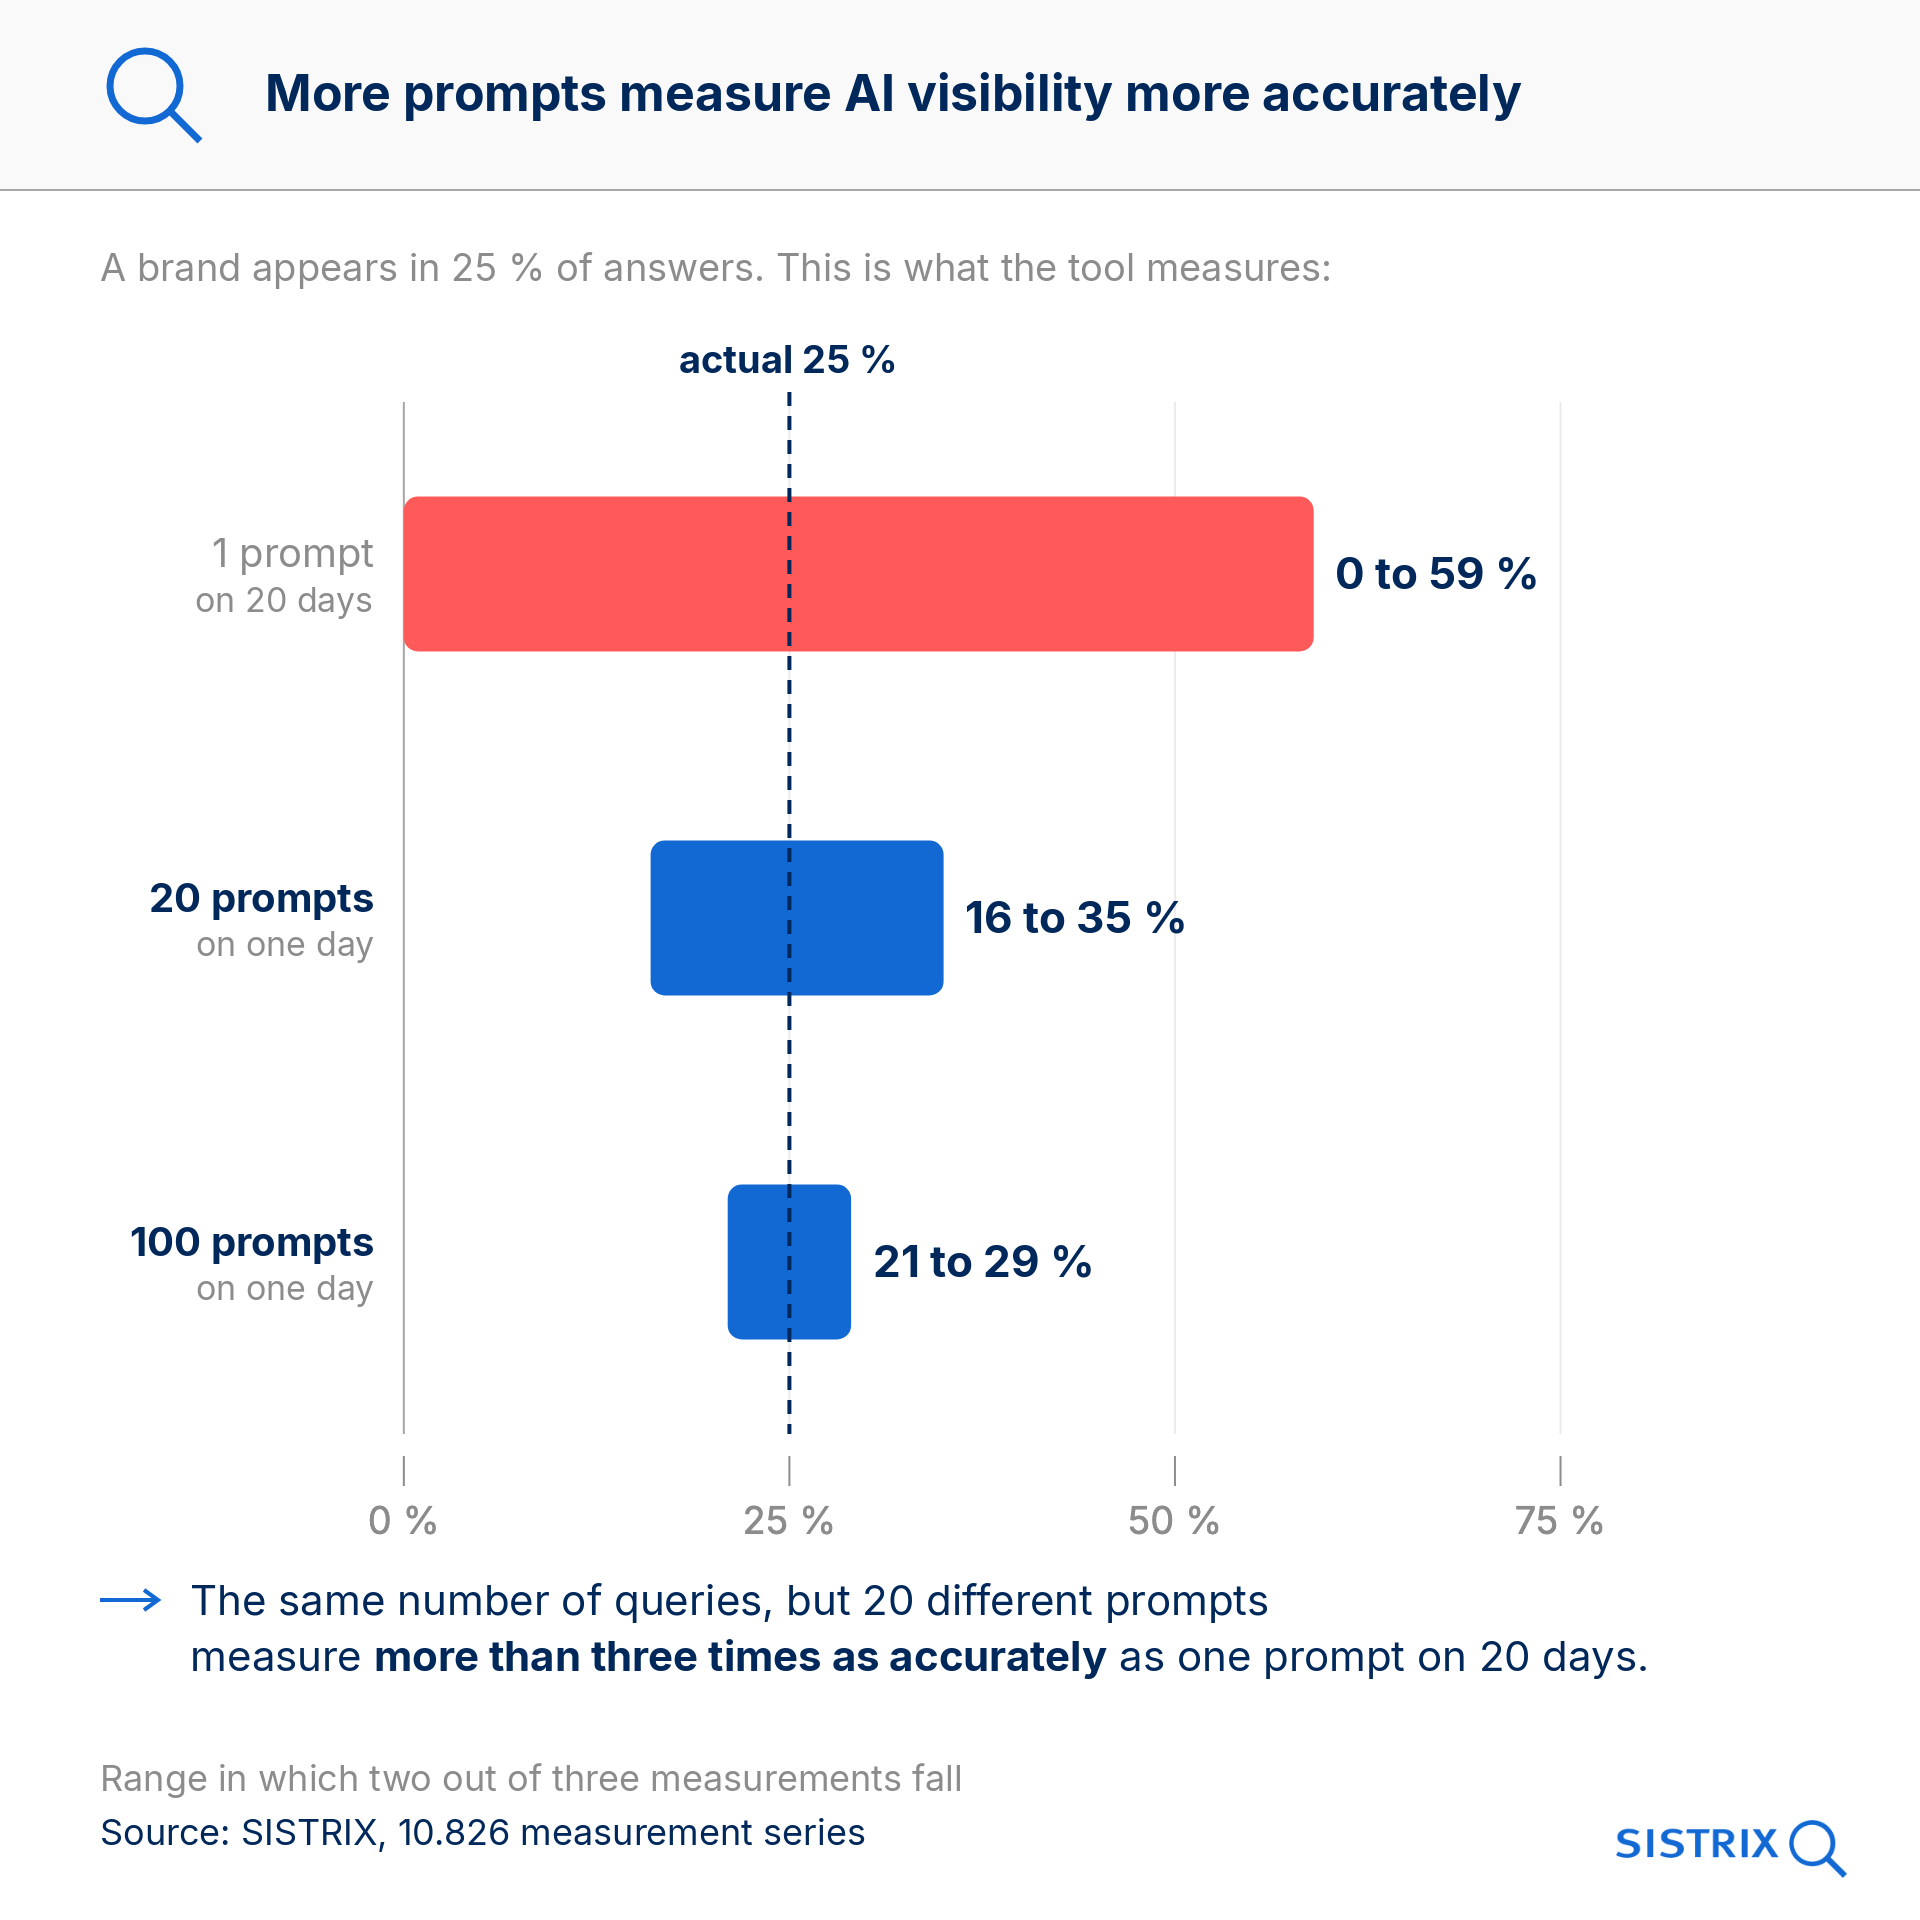
Derrière ces plages se cachent des écarts types par rapport à la valeur réelle : ±34 points de pourcentage pour un prompt, ±9,5 pour 20 et ±4,2 pour 100 prompts. Écart type signifie que, dans environ deux cas sur trois, la mesure se situe dans cette plage, et dans 95 % des cas dans le double de cette plage.
À effort égal, la mesure avec 20 prompts différents est plus de trois fois plus précise que celle d’un seul prompt sur 20 jours. Le constat est quasiment identique pour les quatre modèles et les huit pays : avec 20 prompts, l’écart se situe partout entre ±9 et ±10 points.
Pourquoi la diversité l’emporte
La raison tient à deux types de fluctuations. Un même prompt donne des réponses différentes d’un jour à l’autre. Mais des prompts différents donnent des réponses encore bien plus différentes : pour une question, la marque est presque toujours présente, pour la suivante presque jamais. En moyenne, les écarts entre prompts sont 2,4 fois plus importants que la fluctuation d’un même prompt au fil des jours.
La répétition ne s’attaque qu’à la plus petite des deux fluctuations. Avec 20 prompts, il reste un plancher de ±7,6 points, quel que soit le nombre de répétitions. Pour descendre en dessous, il faut davantage de prompts différents.
En pratique, cela signifie que si tu veux mesurer la visibilité IA d’une marque, mieux vaut interroger 100 prompts par semaine que 15 prompts par jour. L’effort est comparable, mais le résultat nettement plus solide.
De nombreux prompts lissent les fluctuations
Le SISTRIX AI Check montre à quel point cela fonctionne bien en pratique. Pour 60 marques par pays en Allemagne, aux États-Unis, au Royaume-Uni, en France, en Italie et en Espagne, nous avons suivi l’évolution de leurs chiffres d’une semaine à l’autre.
Parmi les prompts dans lesquels une marque est citée, 20 à 55 % changent chaque semaine : la marque disparaît de certaines réponses et apparaît dans d’autres. Pour ChatGPT et AI Mode, c’est environ la moitié, pour AI Overviews environ un prompt sur cinq. Pourtant, le nombre total de mentions ne varie généralement, en net, que de 4 à 10 %. Et plus une marque a de prompts, plus sa courbe est régulière. Pour les marques ayant moins de 100 prompts, la visibilité IA fluctue en médiane de ±5,7 % d’une semaine à l’autre, contre seulement ±1,9 % à partir de 10 000 prompts.
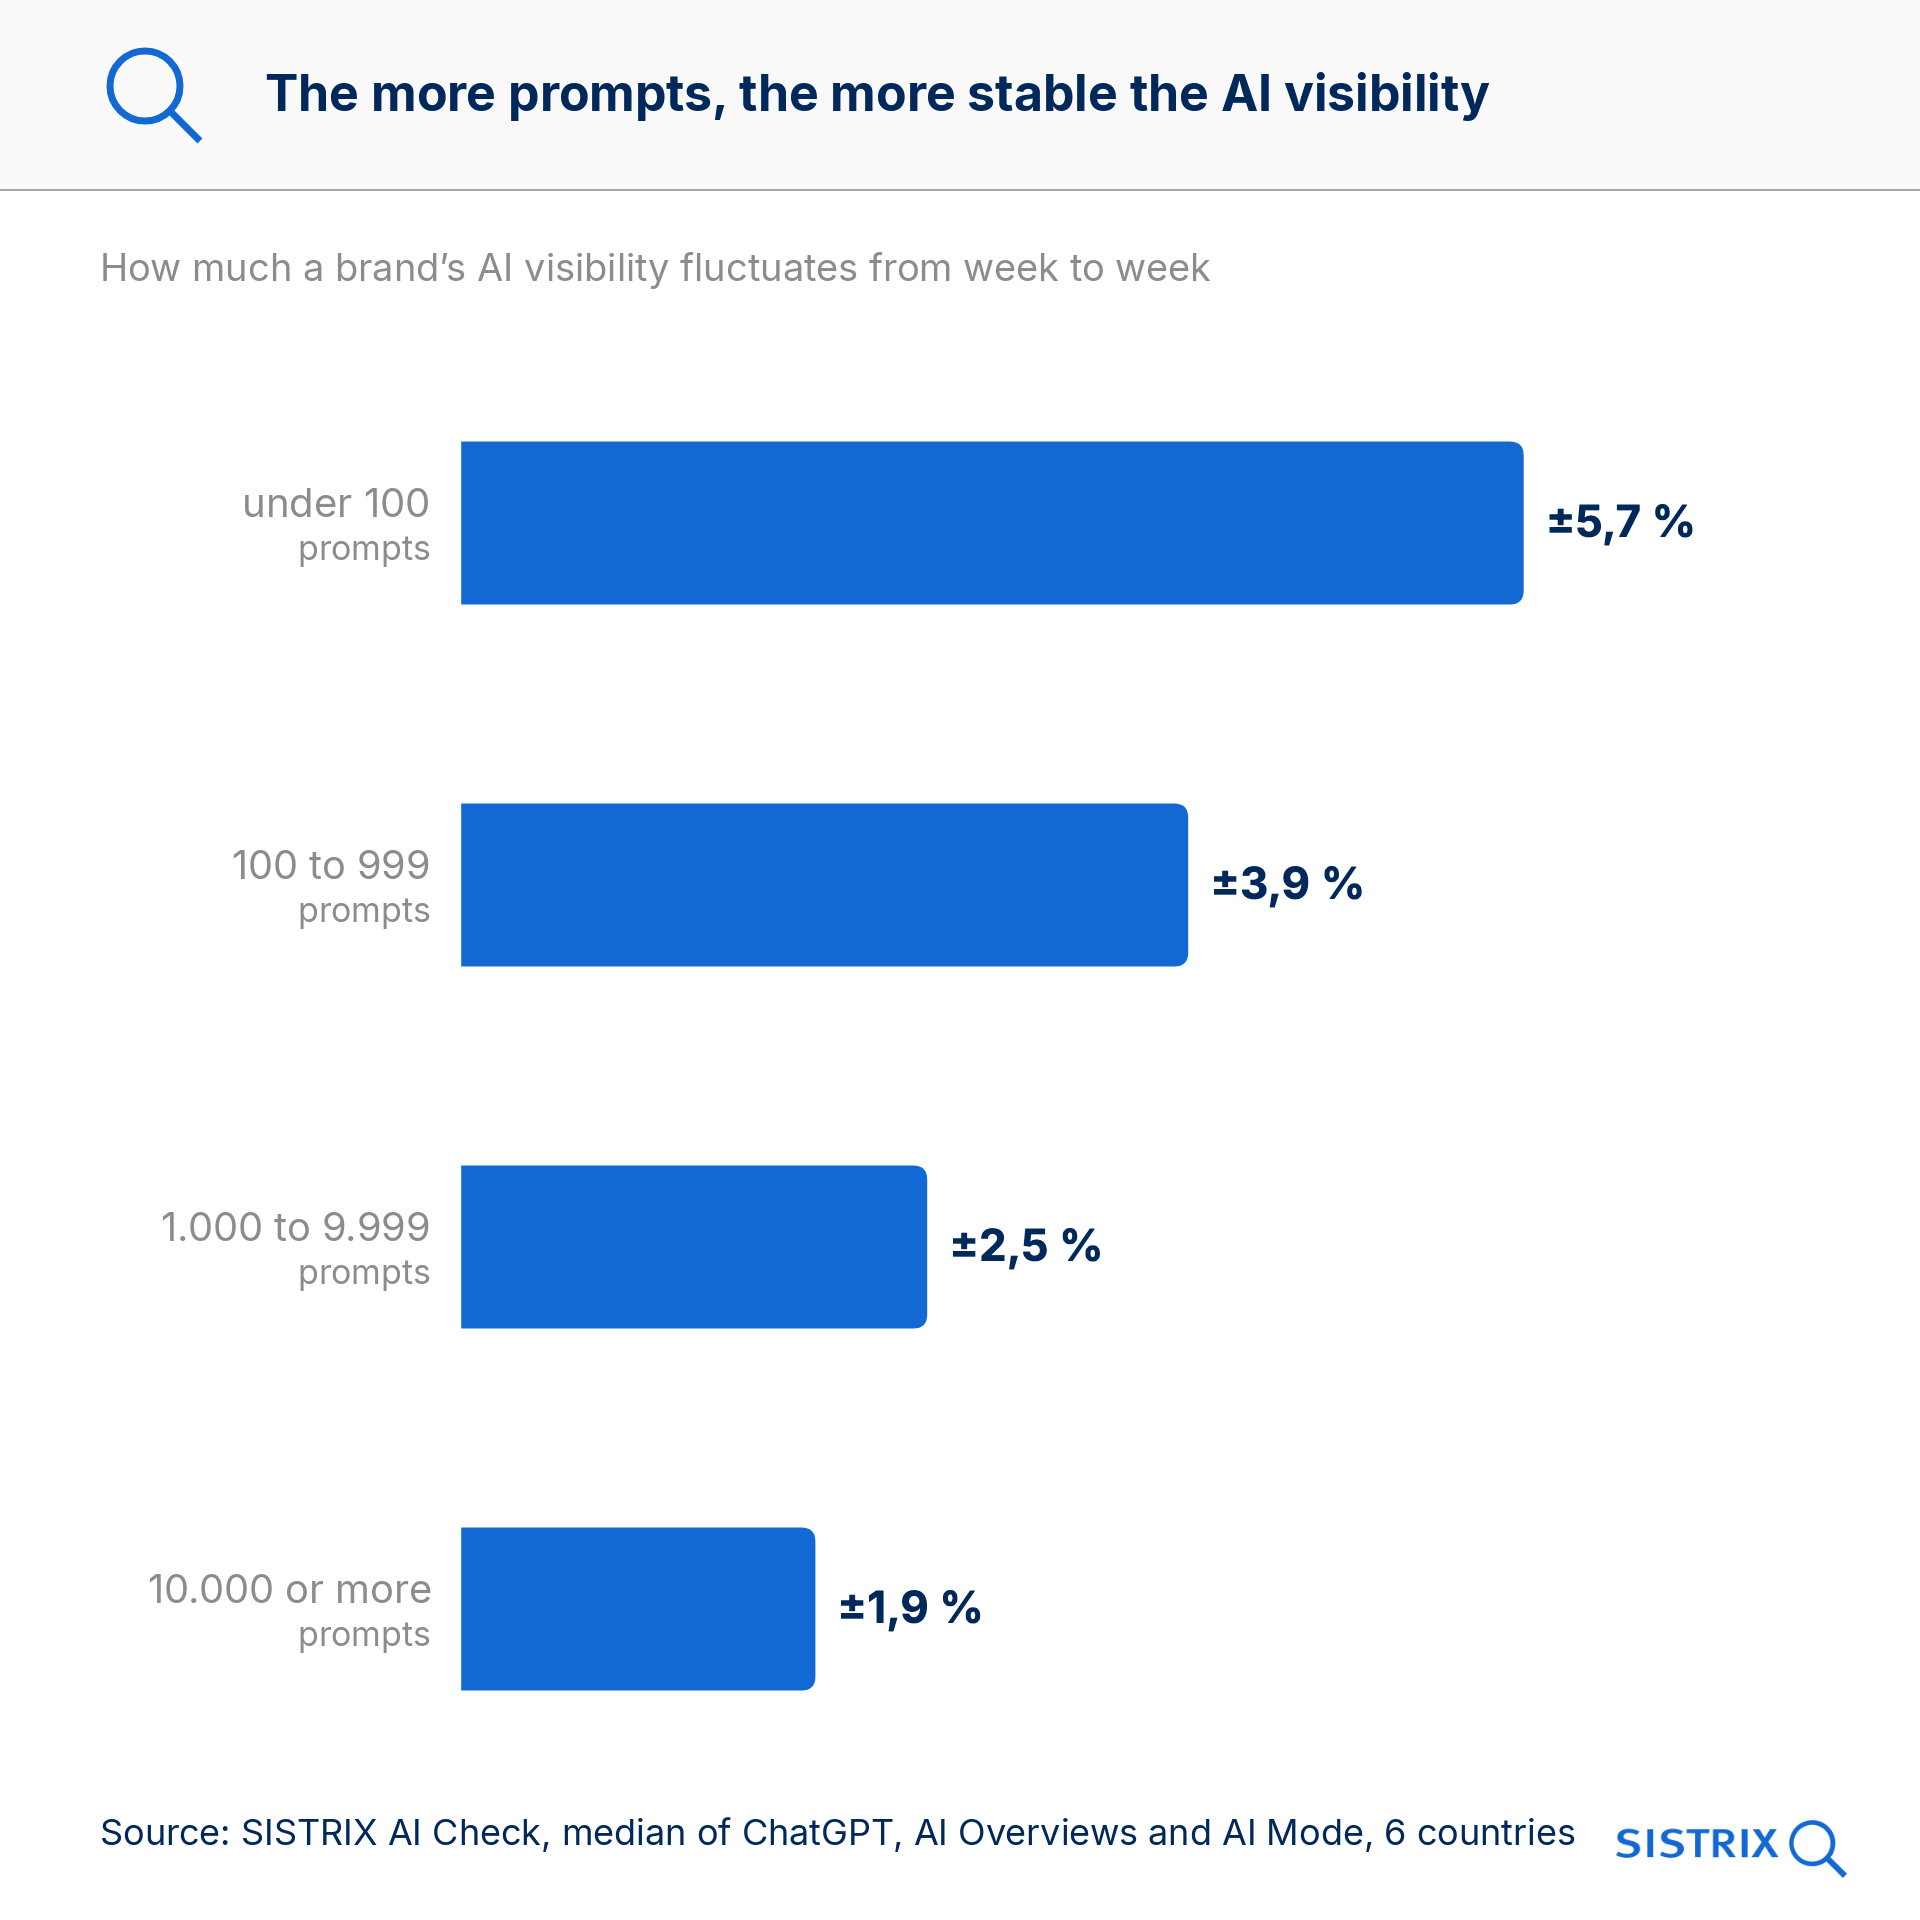
Ce que nous mesurons, c’est l’écart par rapport à la tendance propre de chaque marque, corrigé des variations de la base globale de prompts. Seule exception : les très grandes marques dans AI Overviews, avec ±3,1 %. Pour elles, les changements dans la base de prompts pèsent davantage que le hasard des réponses.
Les réponses individuelles fluctuent fortement, mais le chiffre calculé sur de nombreux prompts reste stable. C’est exactement l’effet dont on a besoin pour une mesure fiable.
Quand les requêtes quotidiennes restent utiles
Sur un point, iPullRank a raison : la répétition n’est pas inutile. Elle répond simplement à une autre question.
« Quelle est ma visibilité ? » se résout par la diversité. « Quelque chose a-t-il changé ? » se résout par la répétition. Si l’ensemble de prompts reste le même, les écarts entre prompts s’annulent dans la comparaison et il ne reste que la fluctuation d’un jour à l’autre. Avec 20 prompts, la valeur quotidienne est précise à ±4,8 points, la moyenne hebdomadaire à ±1,8 point.
Si tu veux savoir si quelque chose a bougé après une action, ne compare donc pas des jours isolés, mais des moyennes hebdomadaires. La moyenne quotidienne sur 20 prompts varie typiquement de 4 à 5 points, et un jour sur dix de 10 points ou plus, sans que rien n’ait changé.
C’est pourquoi de nombreux outils lissent les valeurs quotidiennes sur une fenêtre glissante de 7 jours. C’est pertinent pour suivre les évolutions, mais cela n’apporte pas grand-chose pour le niveau. Mesurés sur sept jours, 20 prompts sont précis à ±7,9 points, à peine mieux qu’en une seule journée (±9,5). Même avec un nombre illimité de jours, on ne descend pas sous ±7,6, car la fenêtre ne lisse que la fluctuation quotidienne, pas le choix des prompts. Les mêmes 140 requêtes, réparties en 140 prompts différents sur une seule journée, atteignent en revanche ±3,6 points.
Précis ne veut pas dire juste
iPullRank distingue la précision (à quel point les résultats d’une mesure sont-ils dispersés ?) de la justesse (atteint-elle la valeur réelle ?) et en conclut qu’en matière de visibilité IA, il n’existe pas de valeur réelle par rapport à laquelle mesurer la justesse.
Nous voyons les choses autrement. Si l’on définit la valeur réelle comme le taux de mention sur l’ensemble des prompts d’un marché, tel que le reflète l’AI Check, la justesse devient mesurable. Et c’est elle la principale source d’erreur.
Nous avons comparé la visibilité de marques dans des ensembles de prompts qu’elles ont choisis elles-mêmes avec leur visibilité dans l’AI Check, à chaque fois sous forme de part par rapport à leurs concurrents. Sans effet de sélection, l’ensemble propre se situerait tantôt au-dessus, tantôt en dessous, et ressortirait donc meilleur dans environ la moitié des cas. En réalité, la marque s’en sort mieux dans son propre ensemble dans trois cas sur quatre, le plus souvent nettement. Selon les concurrents retenus pour la comparaison, ce chiffre va de 63 à 80 %.
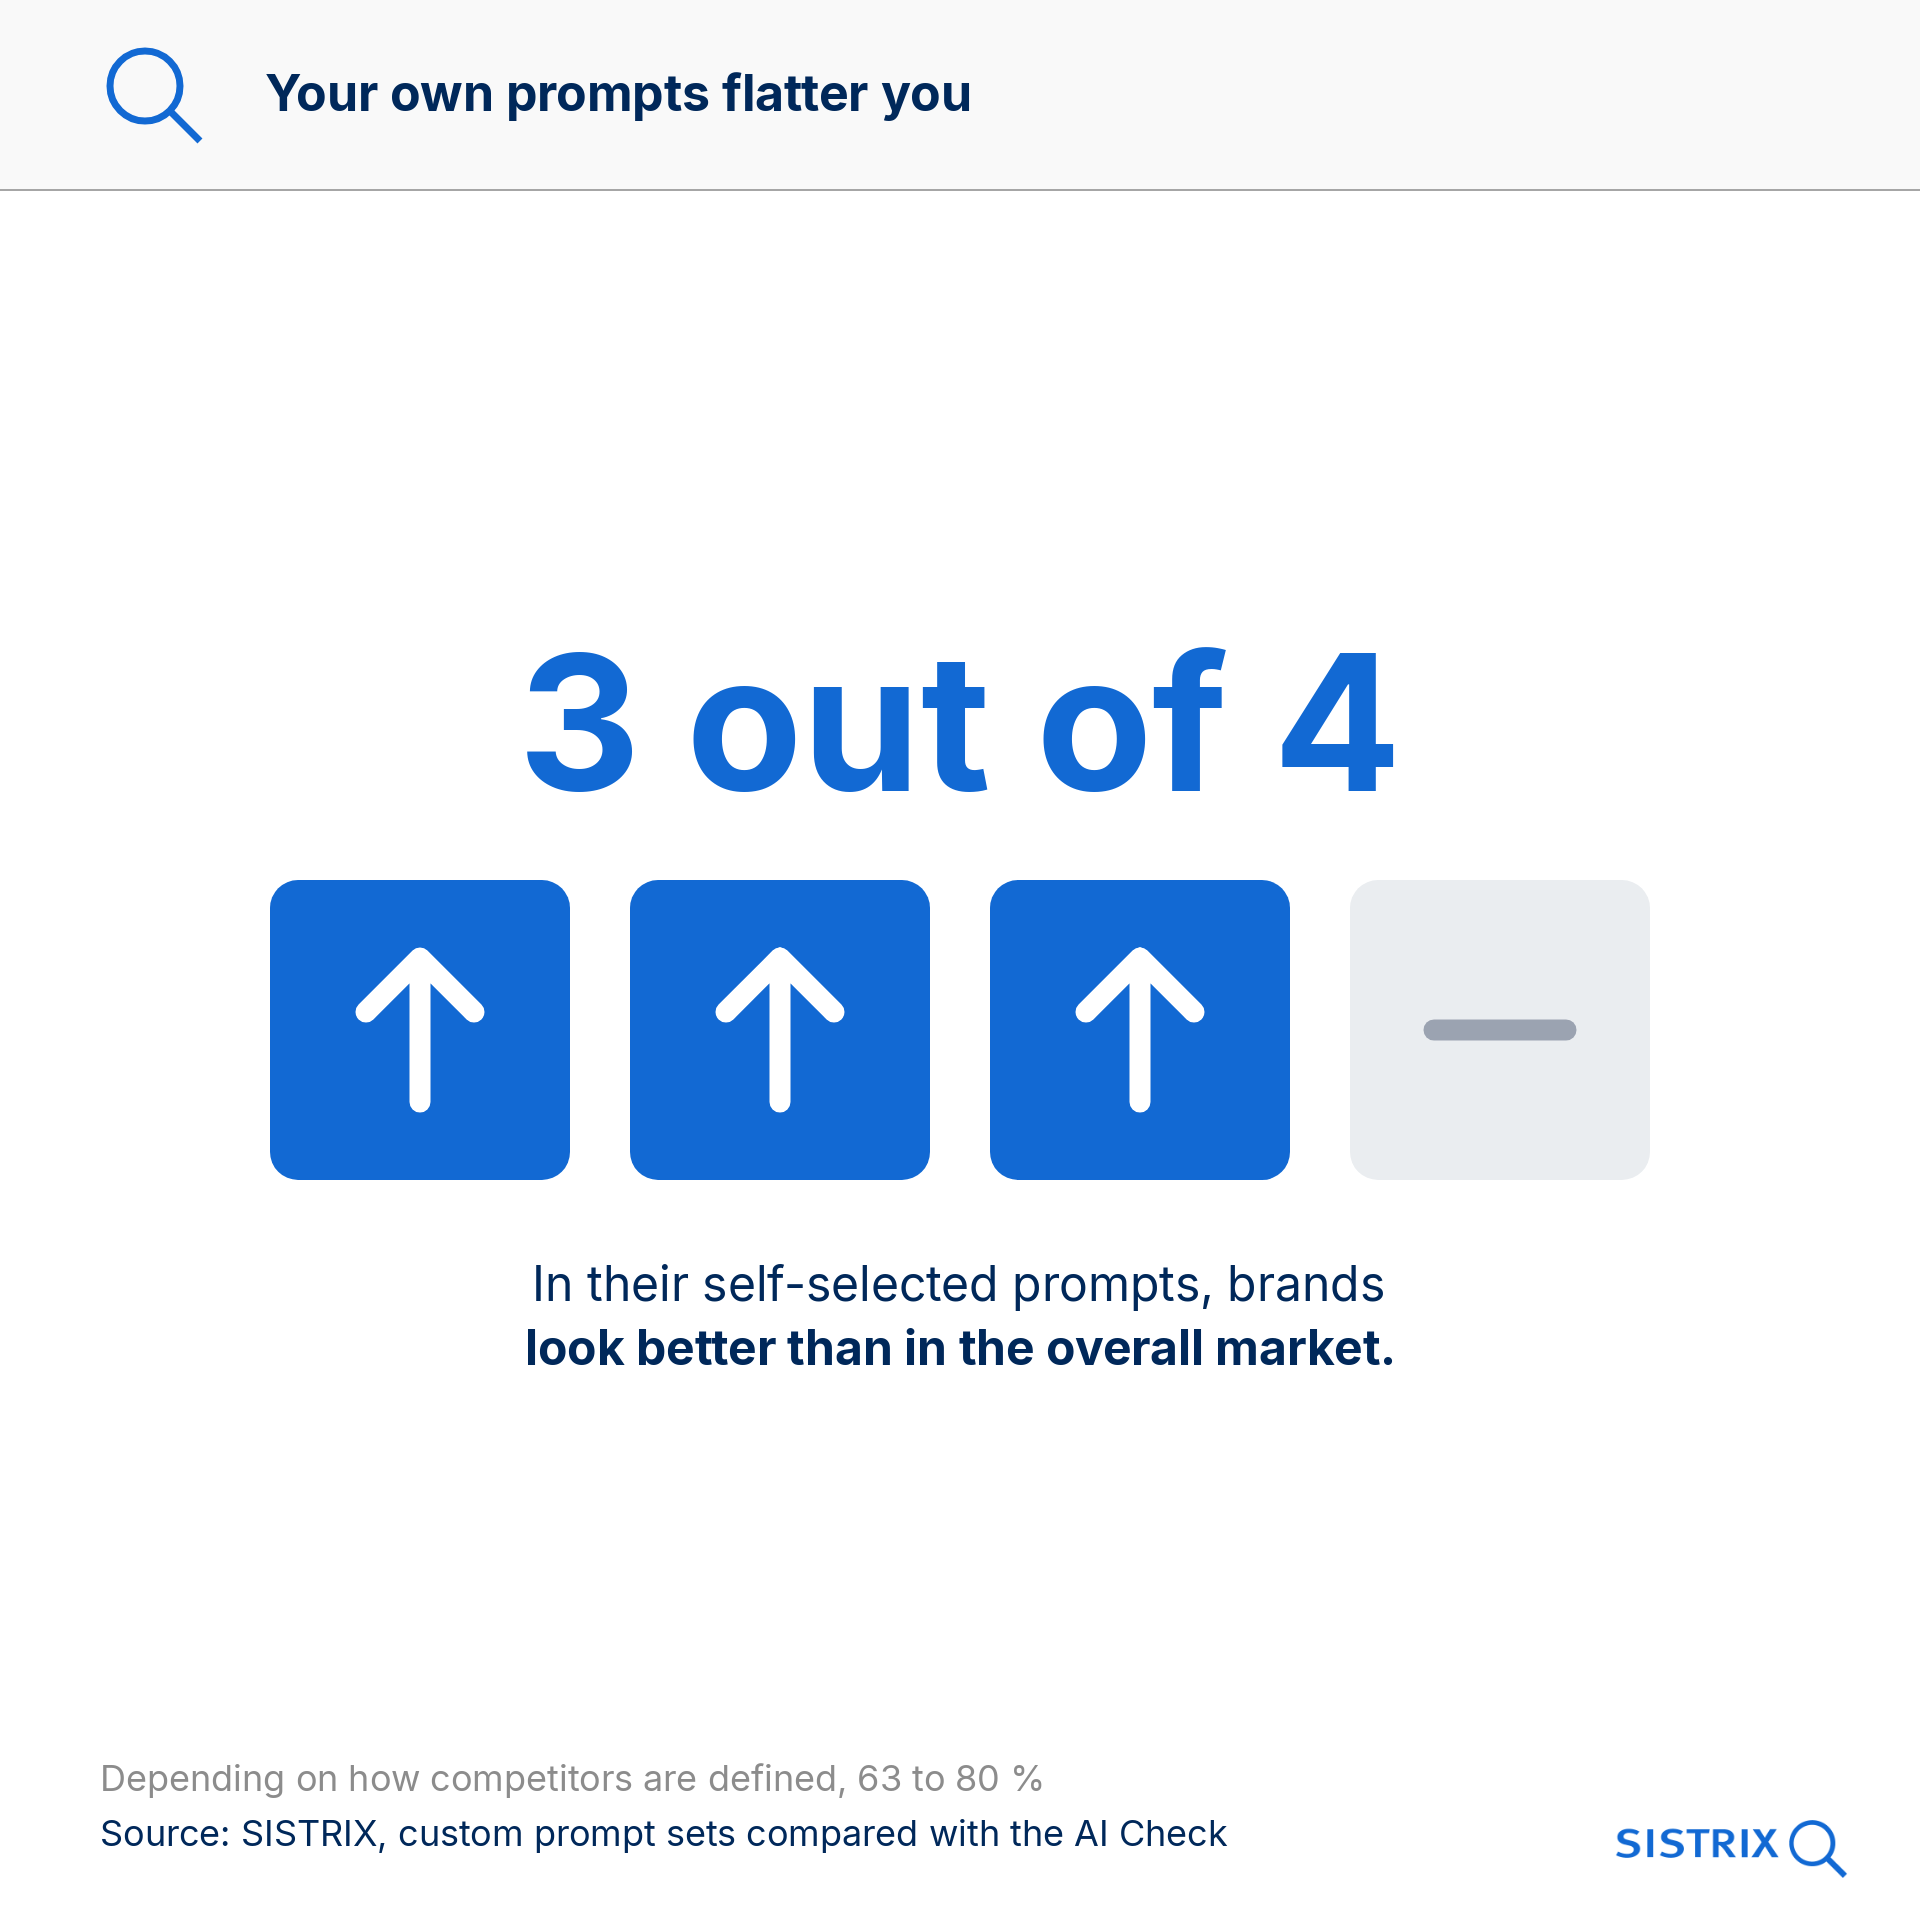
Il ne s’agit pas d’une erreur de mesure, mais d’un effet de sélection. Quand on choisit soi-même ses prompts, on choisit des questions proches de sa propre marque. L’instrument est précis, mais il vise à côté, comme le deuxième joueur de fléchettes de l’illustration de l’article d’iPullRank.
Dans ton propre ensemble : stable pour ta marque, incertain pour les concurrents
Un dernier constat nuance l’image du « coup de dés ». Dans les ensembles de prompts choisis soi-même, la marque ne s’écarte de son résultat habituel que dans 6 % des exécutions quotidiennes. La plupart des prompts la citent presque toujours ou presque jamais.
Cela tient aussi à la sélection : si tu construis tes prompts autour de ta propre marque, tu mesures bien ta marque et toutes les autres seulement à la marge. Ce sont donc surtout les conclusions sur les concurrents et les marques secondaires qui sont incertaines, autrement dit les 70 % qui n’apparaissent que quelques jours. Si tu déduis d’un petit ensemble de prompts choisi par toi qu’un concurrent a progressé, reste prudent. Pour se comparer aux concurrents, mieux vaut une base de prompts qui n’a pas été sélectionnée en fonction d’une marque.
Ce qu’il faut en retenir
Cinq recommandations pour tous ceux qui mesurent la visibilité IA :
- Plus de prompts plutôt que plus d’exécutions. Pour la question « Quelle est ma visibilité ? », le nombre de prompts différents est le levier décisif. Avec 20 prompts, on n’obtient qu’une estimation approximative (±10 points). Pour ±5 points, il faut environ 70 prompts, pour ±3 points environ 200. En règle générale, pour diviser l’incertitude par deux, il faut quatre fois plus de prompts.
- Une fois par semaine suffit pour la diversité. Un grand ensemble de prompts interrogé chaque semaine est plus fiable qu’un petit ensemble interrogé chaque jour. À nombre de requêtes égal, 140 prompts une fois par semaine sont précis à ±3,6 points, contre seulement ±7,9 pour 20 prompts quotidiens avec une fenêtre de 7 jours. Si tu as le budget, investis-le dans davantage de prompts, pas dans des requêtes plus fréquentes.
- Évaluer les évolutions à partir de moyennes hebdomadaires. Les valeurs quotidiennes varient de 5 à 10 points sans raison. Si tu veux savoir si une action porte ses fruits avec un ensemble de prompts fixe, compare des moyennes hebdomadaires. Avec 20 prompts, leur incertitude est de ±1,8 point, contre ±4,8 points pour une seule journée.
- Mesurer le niveau sur le marché, les évolutions dans ton propre ensemble. Les prompts choisis soi-même montrent les tendances de manière fiable, mais donnent le plus souvent un niveau absolu trop flatteur. Pour savoir quelle est réellement la visibilité de ta marque, une large base de prompts comme le SISTRIX AI Check convient mieux que n’importe quel ensemble choisi soi-même. Les indicateurs les plus parlants y sont les parts, comme le Share of Voice, car elles compensent les variations de la base globale.
- Interpréter avec prudence les chiffres des concurrents issus de ton propre ensemble. Un ensemble de prompts choisi soi-même est taillé sur mesure pour ta propre marque. Les concurrents n’y apparaissent qu’à la marge et fluctuent nettement plus. Ce n’est pas le cas dans l’AI Check : chaque marque y est mesurée de la même façon, et la stabilité de son chiffre dépend uniquement du nombre de prompts dans lesquels elle apparaît.
Il en découle une répartition simple des rôles. La visibilité d’une marque se lit sur un très grand nombre de prompts qui n’ont pas été sélectionnés en fonction de cette marque : dans l’AI Check, la visibilité IA des marques comptant plus de 1 000 prompts ne fluctue que de ±1 à 3 % par semaine. Pour savoir si une action fonctionne, il faut un ensemble de prompts fixe dans le Prompt Tracking, interrogé chaque jour et moyenné sur plusieurs semaines. En séparant les deux, on obtient un chiffre juste et une courbe qui montre les évolutions de manière fiable.